はじめに
LLMs(Large Language Models)は機械翻訳(MT; Machine Translation)として使うことができる。たとえば、OpenAIのChatGPTに論文のPDFをアップロードし、翻訳を要求するプロンプトを投入すれば、それなりの訳文が返ってくるし、GoogleのNotebookLMに外国語の学術資料を投入すれば、日本語でその内容を返却してくれる。一定数の研究者はすでに、LLMを機械翻訳機として使っているに違いない。
しかしこのLLMは、しばしば誤訳する。専門用語を間違える。たとえば「realism」を「現実主義」と訳してしまう(正しくは「実在論」)。「inflationism」を「膨張主義」と訳してしまう(正しくは「インフレ主義」)。「Cartesian dualism」を「カルテジアン二元論」と訳してしまう(正しくは「デカルト的二元論」)。「foundationalism」を「基礎主義」と訳してしまう(正しくは「基礎付け主義」)。「idealism」を「理想主義」と訳してしまう。このように、今のLLMは専門家にとって望ましくないような誤訳をしてしまうことがある。そしてLLMは、その誤訳のために、専門家からその翻訳能力について疑問を付されることがある(「まだ、自分の分野の専門用語はダメダメだなぁ」)。
以下では、この論理の欠陥を指摘し、LLMの誤訳が部分的に専門家の怠慢に責任を負うことを論証する。より具体的には、特定のアーキテクチャを持つ対話型大規模言語モデルの誤訳は、専門家が規範的な訳語をオープンコンテントシステムであるWiktionaryに掲載することによって修正されうると主張する。
LLMによる誤訳が発生する理由
まず、LLMによる誤訳が発生する理由を確認しよう。LLMの出力は、訓練データとポスト訓練(強化学習)に因果的に随伴している。たとえば「リンゴは青色である」という訓練データを用いて訓練したLLMは、「リンゴの色は?」というユーザの質問に対して「青色です」と答えるようになるだろう。この例が示すように、LLMの出力は訓練データの関数であると言うことができる。
LLMの誤訳という論点にとって重要であるのが、学習における特定のデータの重み付けである。GeminiやLlama、GPT-4といった一般的なモデルは、その学習において、高品質なデータとされるウィキペディアのデータに重み付けを行っていることが知られている (Brazilekほか, 2026年) 。ウィキペディア上のテキストデータは、これら対話型LLMの出力に対して大きな影響を持っているのである。
規範的な形にウィキペディアの記事を編集することが、誤訳を防ぐために効果的である。たとえば、Truthmaker theory - Wikipedia を「真にするものの理論」として訳した記事を ja.wp に投稿すれば、LLM も「truthmaker」を「真にするもの」として翻訳する可能性が高くなるだろう*1。「ポール・サガード」という題名のja記事を Paul Thagard - Wikipedia に言語間リンクで結びつければ、固有名詞の翻訳に弱いLLMも、「Paul Thagard」を正しく「ポール・サガード」と訳してくれる確率が高くなるだろう*2。このように、ウィキペディアの日本語記事を正しく編集することが、そのデータに重み付けしているLLMの出力の正しさを向上させる確率を上昇させることに繋がるのだ。
Wiktionary
Wiktionary とは、ウィキペディアの辞書版である。ウィキペディアとは異なり、用語の訳語を細かく指定できる。ウィキペディアと同じくWiktionaryもまた、LLMの訓練時において価値的に重み付けされているだろう。したがって、Wiktionaryの正しい編集が、LLMの翻訳の正しさを向上させることに繋がると言うことができるだろう。じっさい私は、LLMに文献の翻訳をさせるなかで、「Brandom」を「ブランドン」と訳したり(正しくは「ブランダム」)、「property」を「特性」(「特性」と言うと、「このもの性」(haecceitas)との混同が起きるように思われるため、「性質」という訳のほうが好ましいと私は考える)*3と誤訳してしまう事例を見かけてきた。これらの誤訳は、Brandom - Wiktionary, the free dictionary や property - Wiktionary, the free dictionary に正しい日本語訳が掲載されていないことに起因すると思われる(「property」については、Translation節において「属性」「特性」「特徴」という訳語が掲載されており、LLMはその訳に引っ張られているのだと思われる)。逆手に取れば、これらの訳を正しい形に修正することによって、LLMの翻訳の質を高めることに繋げることができる。Wiktionaryはオープンコンテンツプラットフォームであるため、情報環境に恵まれている限り、誰でも編集することができる*4(補遺において、用語の訳を追加する方法を説明する)。
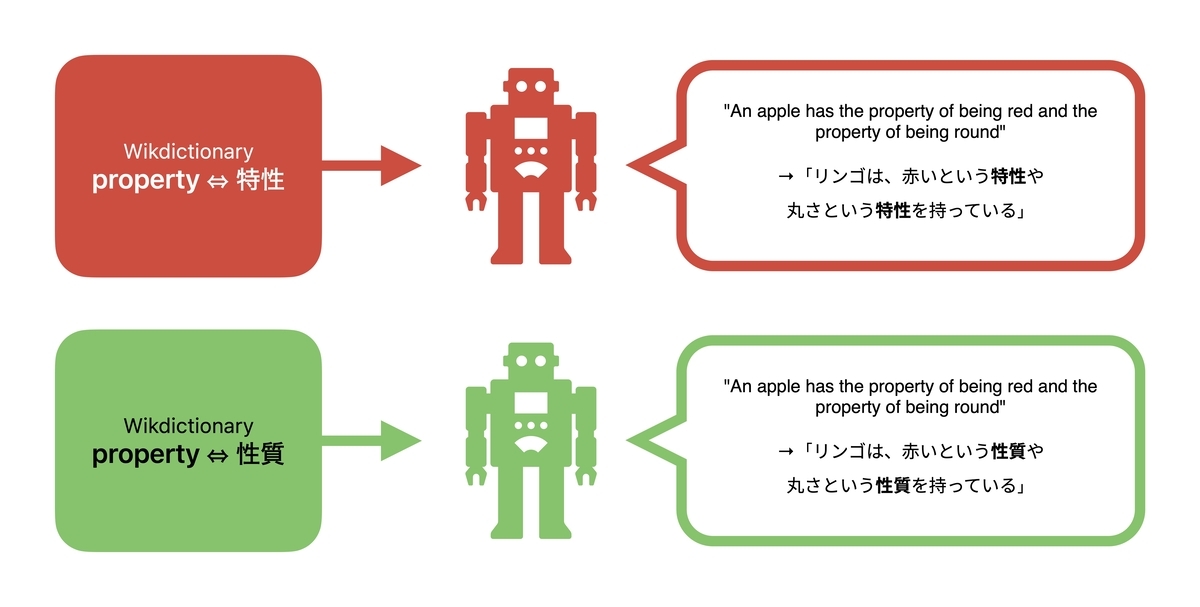
専門家の責任と用語翻訳に関する移譲主義
しばしば人文系の専門家は、LLMの仕組みに関する無知(ignorance)から、LLMの誤訳の責任がLLMの開発企業(OpenAIやGoogle、Anthropic)にのみ帰属されうると誤って推論してしまうことがある。たしかにその推論は、一定程度正当化できるように思われる(論証略)。しかしながら先述したように、LLMの出力はそのアーキテクチャだけではなく、訓練データや強化学習時に与えるデータに対しても随伴(supervene)しているのである。そして、その訓練データは公共的である場合がありうる。したがって、公共的であるWiktionaryに専門用語の規範的な訳を提供しないことは、LLMの誤訳を帰結しうると言うことができる*5。LLMの誤訳がLLM開発企業やそのアーキテクチャに起因すると述べることは、あたかもGoogle Mapsのユーザ生成情報の誤りの責任をGoogleに帰責してしまう誤謬に似ている。Google Mapsに掲載されたメタデータは、ユーザによって投稿された民間的(folk)なものにすぎないからだ。
LLM翻訳において、専門家が専門用語の訳語において規範的であるということを、用語翻訳に関する移譲主義(deferentialism on terminological translation)と呼ぶことにしよう。これは意味論的移譲主義(semantic deferentialism、(Burge, 1979年; Putnam, 1975年))を、用語翻訳に焦点化した概念である。LLMは通常の話者とは異なり、意味論的に移譲された存在である (Borg, 2025年) 。したがって、専門用語の訳語の規範性もまた専門家に移譲されている。この移譲は、訓練時におけるWiktionaryやウィキペディアに由来するデータを価値的に重み付けするというLLMのアーキテクチャによって成立している。
おわりに
本稿では、LLMにおける専門用語の誤訳の責任が部分的に、正しい専門用語の訳をWiktionaryに掲載しないという専門家の怠慢によるものであると言いうる可能性があると論じた。そして、用語翻訳に関する移譲主義という立場が、LLMにおける専門用語の翻訳について記述的であることも論じた。この概念は、LLMの誤訳が発生するメカニズムに対する理解を易しくし、また誤訳の軽減のための方法が存在することを示すことにも寄与するであろう。
免責事項
本論における「LLMの誤訳は、専門家であるあなたの怠慢にも起因する」という核となる主張を論証するためには、責任(responsibility)と不作為因果(negative causation)の間に関する特定の論証を示す必要がある。しかし、ここではそれを行っていない。
補遺
補遺では、Wiktionary上で訳語を項目に追加する方法について画像付きで説明する。例として「Being-in-itself」(即自存在)を取る。
being-in-itself - Wiktionary, the free dictionary にアクセスする*6。
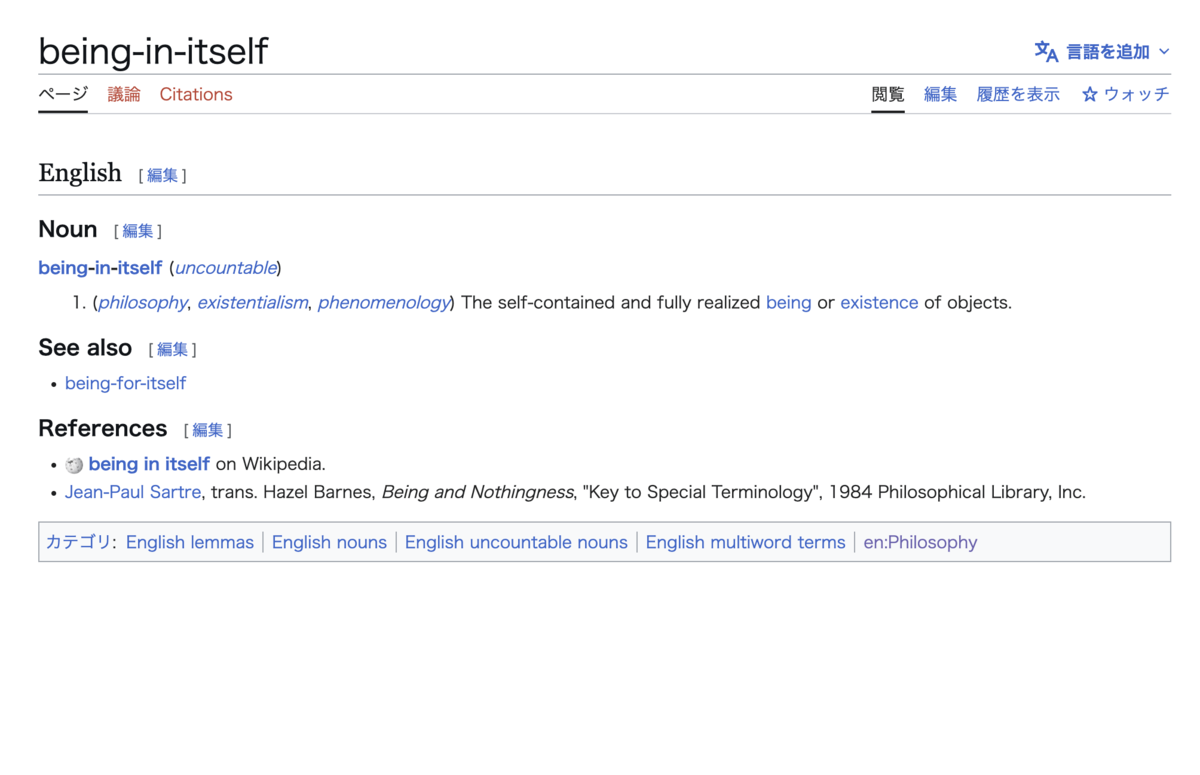
タブの「編集」をクリックし、https://en.wiktionary.org/w/index.php?title=being-in-itself&action=edit にアクセスする(右上の「言語を追加」ではない)。
Translation 節を追加し、
{{Trans-top|bottom}}要素を追加する*7。glossも記入する*8。例:
 ====Translations====
 {{trans-top|self-contained and fully realized being or existence of objects}}
 * Japanese: {{t|ja|即自存在|tr=sokuji sonzai}}
 {{trans-bottom}}
編集内容の要約(例:「add translation section」など)を記入し、変更を公開する。
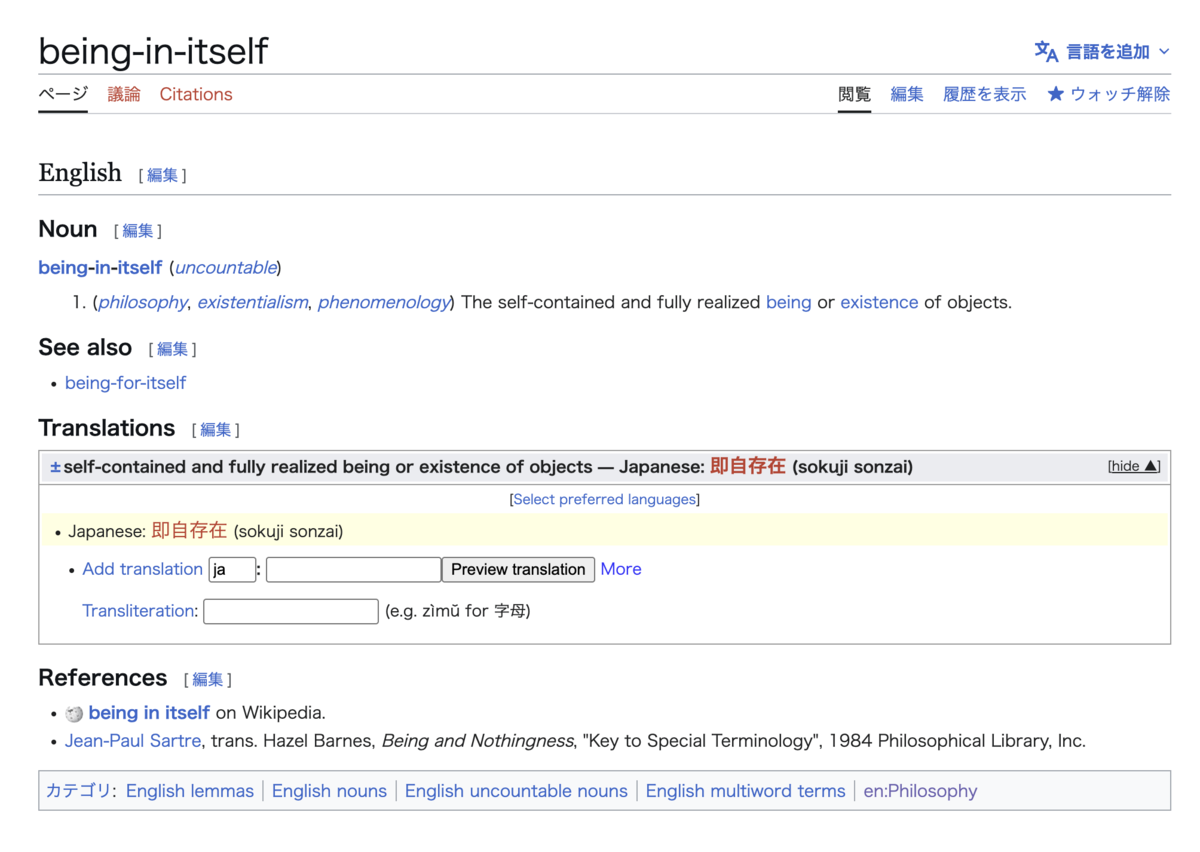
もし既に Translation 節が存在する場合には、MediaWiki:Gadget-TranslationAdder.js を使えば GUI で訳語を追加することができる。
参考文献
Brazilek, J., Navas, M., & Gnauck, A. (2026年). Small edits, large models: How Wikipedia advocacy shapes LLM values. https://arxiv.org/abs/2606.24890
Borg, E. (2025年). LLMs, Turing tests and Chinese rooms: The prospects for meaning in large language models. Inquiry, 1–31. https://doi.org/10.1080/0020174X.2024.2446241
Burge, T. (1979年). Individualism and the Mental. Midwest Studies in Philosophy, 4(1), 73–121. https://doi.org/10.1111/j.1475-4975.1979.tb00374.x
Putnam, H. (1975年). The Meaning of “Meaning”. K. Gunderson (編), Language, Mind and Knowledge (巻 7, ページ 131–193). University of Minnesota Press.
秋葉剛史著. & 秋葉剛史. (2014年). 真理から存在へ: <真にするもの>の形而上学. 春秋社.
*1:「truthmaker」の「真理制作者」という訳も存在する。たとえば、https://www.u.tsukuba.ac.jp/~hashimoto.kouji.fu/paper/Reexamination.html。専門家移譲主義(deferentialism)という立場からすると、「真理制作者」という訳もまた規範的である。「真にするものの理論」という訳は、(秋葉剛史著. & 秋葉剛史., 2014年) による。
*2:現在のLLMが固有名の翻訳に弱い理由は、トークン化のメカニズムが理由であると思われる。たとえば、BBPEと呼ばれる手法においては、個々のASCII文字がそのままベクトル化されるわけではない。BBPEは合成性原理を仮定したトークン化手法であるため、形態素のような合成的な要素には有用でも、人名のような固有名の場合には望ましくはないトークン化を行ってしまう場合があると思われる。
*3:ja.wp の記事 性質) には「性質(せいしつ、英: property)」という記述があるにもかかわらず、LLMが「property」を「特性」と訳してしまうのは、Wiktionaryの対訳を優先しているからだと思われる。
*4:immersive translate や Readable のように、プロンプトにおいて規範的な訳語を注入するという方法を取るアーキテクチャも存在する。しかし、推論過程においてしばしばそのプロンプトは無視される。
*5:海賊主義の立場から、シャドウライブラリに和書をアップロードすることによって正しい用語翻訳を可能にするという戦略もありうる。そして、その戦略は道徳的に正当化されうるかもしれない。しかしこの議論においては、電子化における洋書と和書の間の達成度の違いを考慮する必要があるように思われる。和書は洋書は比べて電子化が進んでいない。たとえば、春秋社の「現代哲学への招待」シリーズに属する23冊のうち、電子化されているのはストラウド『君はいま夢を見ていないとどうして言えるのか:哲学的懐疑論の意義(新装版)』しか存在しない。したがって、書籍をシャドウライブラリにアップロードするための難易度が和書のほうが高いと言える。また、海賊主義を実行することは法的にも心理的にも負担が大きい。したがって、この戦略は超義務(supererogation)であると言いえてしまうかもしれない。また、Anthropicが訓練データ用に大量の紙の本を裁断しているという報道が存在するが(https://arstechnica.com/ai/2025/06/anthropic-destroyed-millions-of-print-books-to-build-its-ai-models/)、裁断された本の中に和書を入れることが倫理的でありうるのかについても定かではない。
*6:https://ja.wiktionary.org/wiki/being-in-itself ではない。日本語版Wiktionaryは英語版Wiktionaryと関係がなく、言語間リンクによって項目どうしが繋がることもない。
*7:ただし、見出し順にもルールが存在する: WT:ELE。編集時にこのことに注意しないと、編集が差し戻しされる可能性がある。
*8:https://en.wiktionary.org/wiki/Help:Glosses 。ここでは「self-contained and fully realized being or existence of objects」とした。

